一个工单按固定规则分派,与分析多份未知结构的资料,是两种不同任务。前者可以先评估单工作流,后者再评估 Claw 的自主执行能力;模式选择应服从任务结构,而不是追逐更复杂的名称。
哪些任务更适合先评估单工作流?
官方 ADP 概述把单工作流定位于已固化的标准化流程,例如条件判断、API 查询和结果处理的组合。[4] 深云建议先画出输入、分支、输出和失败路径,再判断流程是否足够稳定。
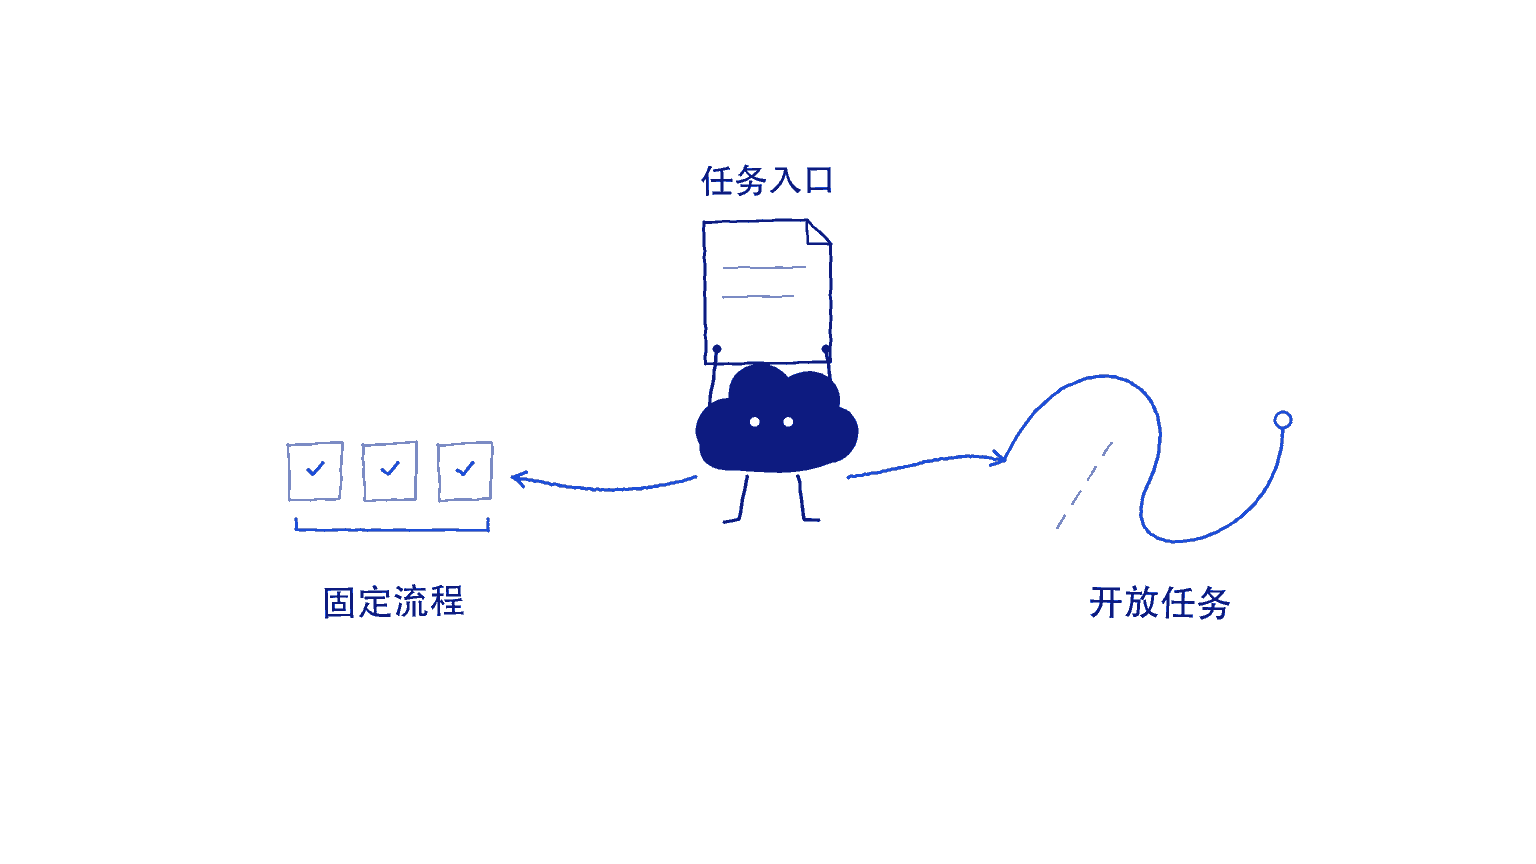 固定流程与开放任务,应走不同处理路径。 原创示意,非产品界面或客户案例。
如果每次都需要先核对编号、查询状态、根据条件转交负责人,步骤已经明确,就不必让智能体每次重新规划。把必填字段和分支条件写清楚,方便业务人员审查错误发生在哪一环。
流程固定不代表模型输出确定。包含文字分类或摘要的节点仍要校验,涉及创建工单、修改数据和通知客户时,应单独检查授权、重复请求和结果回读。以下是方案建议,不是平台默认控制能力的保证。
什么情况下值得验证 Claw?
官方说明 Claw 具有独立工作空间,可以自主编写、运行代码,并使用 Skills、连接器与工具,适合数据分析、内容生成和自动化处理等任务。[4] 实施前仍应明确可访问的数据与可执行动作。
当任务目标确定,但资料格式和处理步骤需要根据输入探索时,可以用脱敏样本测试 Claw。要求保留输入副本、说明处理步骤,并输出可打开的文件;不能只凭最终对话显示“完成”判断任务成功。
如果只是常规知识问答,先测试标准模式即可。只有确实存在不同职责的协作和交接需求时,再考虑 Multi-Agent;多个模型同意同一个结论,也不能替代原始证据。
如何比较两种方案,而不被演示效果误导?
使用相同的授权资料和目标任务,分别记录结果正确性、权限行为、人工返工、异常处理与实际资源消耗。ADP 官方流程把调试评测放在发布前,并要求上线后持续观察运行情况。[5]
测试集同时包含正常任务、缺少字段、接口超时和无权限请求。为每一项定义预期行为,检查系统是否停在正确边界,而不是为了产出答案自行猜测或继续写入。
深云建议把选择理由写成可复查的结论:任务步骤是否固定、是否需要自主执行、增加复杂度解决了什么问题。本文依据国际站能力说明,不承诺不同站点、地域或订阅拥有完全相同的配置。
常见问题
Claw 出现后是否就不需要 Workflow?
不是。固定步骤与开放式任务仍有不同需求,先选择便于审查和维护的最小实现,再根据证据扩展。
多个 Agent 是否一定更准确?
不能保证。应验证分工与资料依据,比较实际结果、成本和返工情况,不能把智能体数量当成质量指标。
参考资料与核验时间
以下公开资料于 2026-09-25 核验。产品能力、订阅、活动和价格以当期官方说明及实际适用条件为准。本文不是客户端实测报告,示例方案不代表客户已部署。
从一项具体任务讨论交付
深云可围绕 WorkBuddy 交付、FDE 前置部署与腾讯云生态评估企业 AI 场景。建议准备现行流程、授权资料与验收样例;具体方案、费用与责任以双方确认范围为准。
联系深云评估 →