判断企业 AI 是否值得推广,应比较完成同一项合格业务任务需要的总投入,而不是只比较模型生成用了多久。先记录人工流程,再记录 AI 处理、人工复核、返工和异常接管,才能看清适用范围。
人工基线应记录什么,而不只是工时?
深云建议先固定任务输入、合格输出和判断规则,记录处理时间、等待时间、复核时间、返工原因与失败任务。没有统一合格标准,速度对比很容易变成两种不同工作的比较。
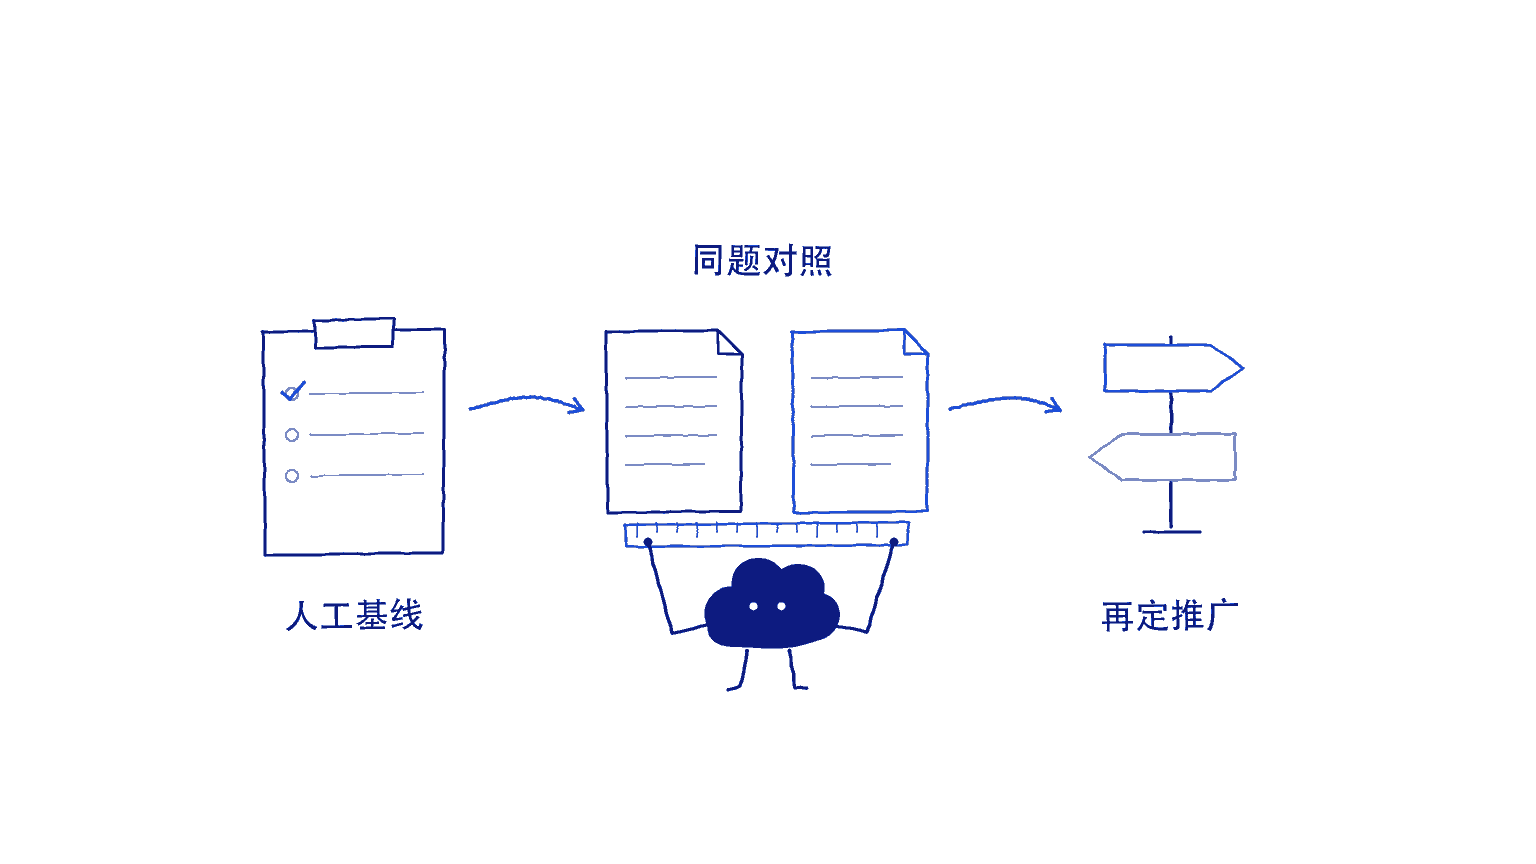 先建立人工基线,再用同题对照决定是否推广。 原创示意,非产品界面或客户案例。
例如,整理资料形成内部答复草稿,可以约定必须标注有效来源、不得猜测缺失条款、由指定负责人审核。人工和 AI 都使用相同的授权资料与统计时间,避免一方拿到更完整的信息。此处是评估方法示例,不是客户项目数据。
不要只挑最容易的任务。按业务常见情况加入资料缺失、格式不一致、异常接口和需要人工判断的样本,保留未完成记录;只统计成功任务会隐藏实际接管成本。
使用 ADP 等平台,怎样观察真实业务结果?
ADP 官方使用流程包含调试、关键场景测试、批量评测和发布后持续运营,并列出请求量、成功率、延迟与 Token 消耗等观察方向。[5] 企业仍需补充自己的任务质量与人工复核记录。
平台请求成功与业务完成要分开。例如接口返回数据,不代表报告中的解释正确;模型给出“已经处理”,也不代表目标业务记录已经更新。每项任务应保存实际产物和业务确认,不用聊天轮数作为产出。
测试模型、提示词或知识库时,尽量只改变一个因素,并保存输入和配置标识。重新运行后比较同一组任务,说明哪些变化可能来自资料更新,不能把所有差异归因于模型升级。
什么时候扩大使用,什么时候保留人工流程?
建议在质量、权限和异常处理均符合业务要求后,先扩大有限范围;对于高返工、难以发现错误或高风险写入的任务,继续保留人工主导。NIST AI RMF 是自愿风险管理框架,不是部署合格认证。[12]
由业务和技术负责人提前约定放行条件,不设置适用于所有场景的统一准确率。即使平均指标不错,未授权访问或错误业务写入也应独立处理,不能被其他成功任务抵消。
向更多部门推广前,确认资料维护、日常支持和退出责任。深云建议把 WorkBuddy 交付、ADP 应用建设及 FDE 实施放到具体任务中讨论,而不是先购买全部组件。没有真实基线时,本文不提供节省比例或投资回报承诺。
常见问题
是否只需记录 AI 的生成时间?
不够。应同时记录准备资料、人工复核、返工、接管和工具使用投入,并以合格任务为对比单位。
试点必须同时使用 WorkBuddy 和 ADP 吗?
不必须。先定义员工任务与专属应用需求,再核对产品、接口和维护条件;两者组合需单独验证。
参考资料与核验时间
以下公开资料于 2026-09-25 核验。产品能力、订阅、活动和价格以当期官方说明及实际适用条件为准。本文不是客户端实测报告,示例方案不代表客户已部署。
从一项具体任务讨论交付
深云可围绕 WorkBuddy 交付、FDE 前置部署与腾讯云生态评估企业 AI 场景。建议准备现行流程、授权资料与验收样例;具体方案、费用与责任以双方确认范围为准。
联系深云评估 →